
上下文: Capgo营销网站。角色: 短UI标签或导航项。见于: 组件 BlogAuthorByline.astro。 什么是可观测性以及你的应用需要它不是仅仅 为什么某件事情失败了.
Your mobile release has just reached production. An alert says the update service is healthy, the API dashboard is green, and the error rate looks normal. Then support reports that users on one device model are stuck on an older bundle, while another group sees a blank screen after launch. You can see the symptoms, but not the path that produced them.
That’s the difference between knowing something broke and being able to explain it. A metric can show that downloads slowed. A trace can reveal whether the delay came from the client, update service, or API. A log can expose the checksum mismatch, rejected bundle, or JavaScript exception that caused the failure.
Modern applications make this context harder to preserve. A Capacitor app may involve native code, a web layer, remote APIs, authentication, analytics, a live-update service, and a particular device or operating-system version. An Electron application adds its own desktop runtime and environment differences. When a release changes quickly, predefined alerts rarely anticipate every failure mode.
Observability 为工程师提供了一种方法来调查那些不熟悉的情况而不需要猜测。它帮助团队更快地诊断事件、以更清晰的证据发布更新,并将技术行为与用户体验联系起来。以下示例从定义和三个经典支柱开始,逐步实现实践、商业价值和对 Capacitor 和 Electron 应用程序的实时更新。
目录
- 软件系统中的可观察性真正是什么意思
- 构成系统可观察性的三个支柱
- 可观察性与监控的区别以及它们如何一起工作
- 可观察性现在成为商业能力的原因
- 最佳实践、最佳实践和权衡
- Observability in Action for Capacitor Electron and Capgo Live Updates
软件系统中的可观察性真正的含义
可观察性 这个词 在软件领域以外 在 1960 年代Rudolf Kálmán 将其应用于控制理论 用来描述工程师如何从系统输出中推断系统内部状态如本文所述的可观察性历史 这个概念后来通过分布式系统的工作进入了软件实践 描述一个“可观察性堆栈”。日志、指标和跟踪的三柱模型已经成为标准。 2018,根据同一参考资料。
汽车仪表盘提供了一个有用的比较。速度表告诉你你正在移动的速度,油量表显示剩余油量,警告灯指示已知条件。这是有用的监控。一个引擎诊断系统进一步。它结合了传感器读数和错误记录,以帮助解释引擎为什么会故障。
软件可观察性与此类似。它不意味着收集每个可能的记录而没有目的。它意味着产生足够的连接证据,使工程师能够推断应用程序内部正在发生什么,即使应用程序分布在服务、设备和运行时之间。
分布式应用程序中的输出为什么重要
你经常无法暂停生产系统并逐步执行每一行code。请求在组件之间移动,容器发生变化,用户运行不同的版本,失败可能在你在本地复制它们之前就消失了。外部输出成为你的证据。
云原生应用程序通常有几个相互依赖的部分,因此了解其架构提供了必不可少的背景。一个实用的 云原生架构指南 可以帮助团队在决定要哪些组件进行监控之前,推理这些依赖项。
对于一个 Capacitor 应用程序,可能有用的输出包括:
- 客户端事件,例如应用程序启动、包下载、验证、激活和回滚。
- 性能指标,例如启动延迟、请求延迟、更新失败和崩溃次数。
- 分布式跟踪,连接用户操作到应用程序、 API 门户、后端服务和数据库。
- 结构化日志,携带设备、应用程序版本、渠道、交易 ID 和错误上下文。
关联性是属性。一个设备标识符或跟踪 ID 可以连接一个更新尝试、下载结果和随后的运行时错误。没有这种关系,每个仪表板只显示一个碎片。
对于移动设备的视角, Capgo 提供了 移动应用程序可观察性指南 探索应用程序遥测如何支持发布诊断。更广泛的原则仍然简单: 可观察系统让您使用已捕获的证据询问行为的新问题.
构成可观察系统的三大支柱
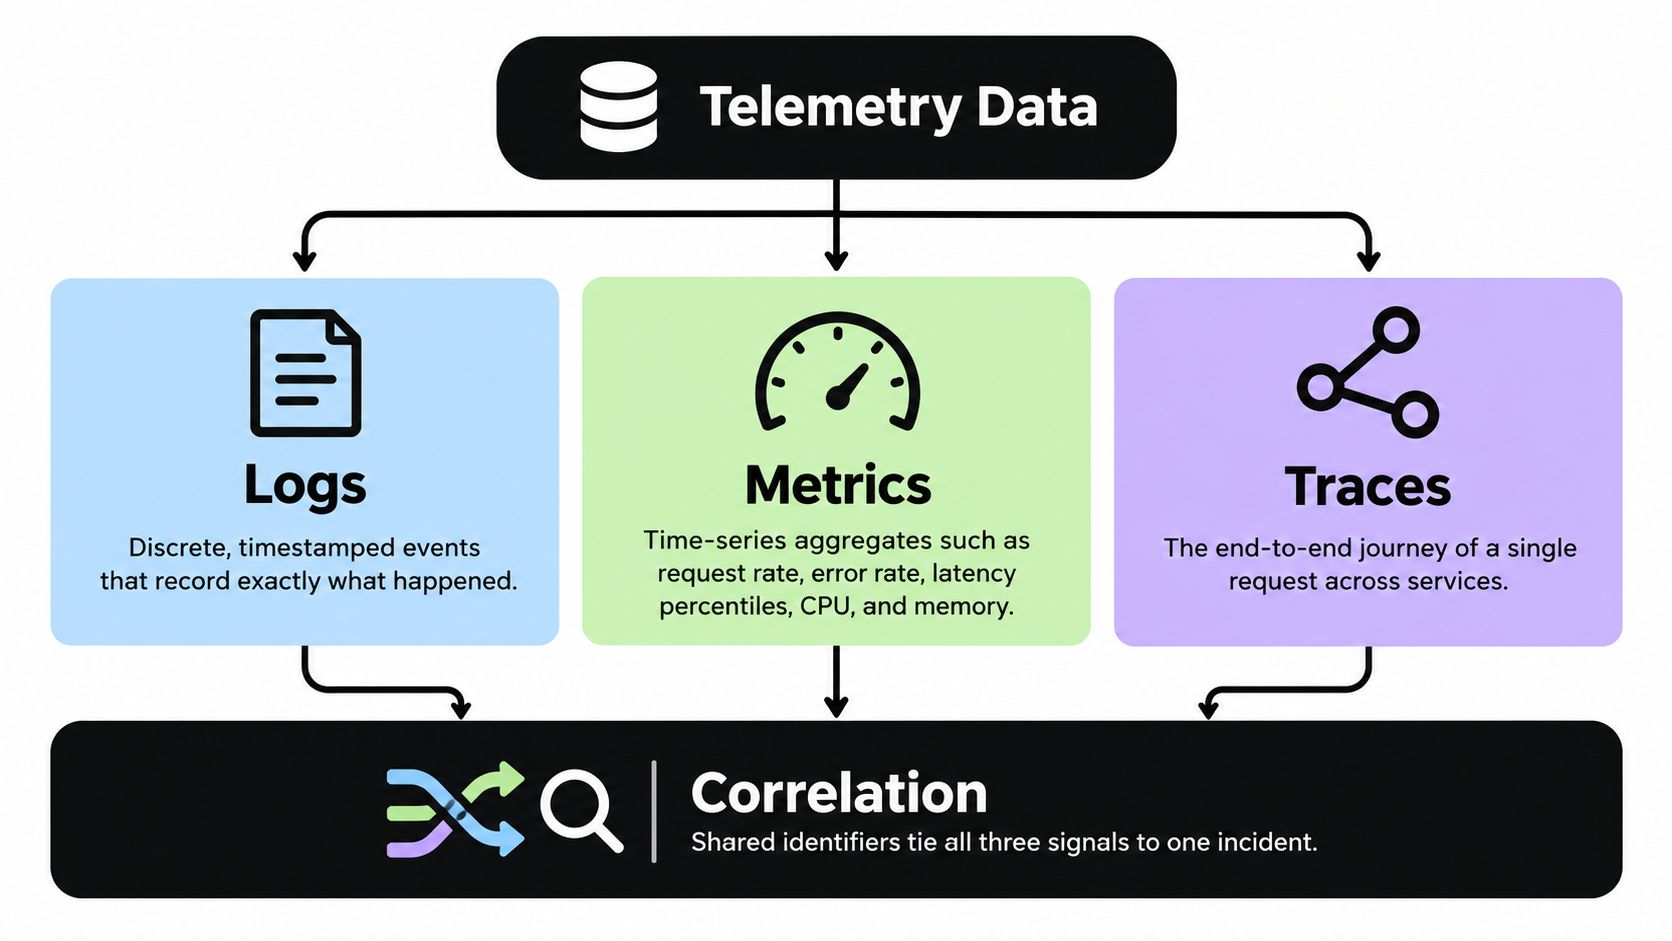
日志、指标和跟踪有不同的形状,回答不同的问题。可观察性在于工程师在同一请求、发布、用户旅程或设备上将它们关联起来时变得有用。
指标 是时间序列聚合。例如,请求率、错误率、延迟百分位、CPU和内存。它们将许多事件压缩成一个易于图表化和设置警报的值。一个指标可能会告诉您部署后捆绑激活失败增加了,但它不会确定具体的设备或异常。
跟踪 重建了请求在服务之间的端到端路径。每个路径部分由一个span表示。如果一个更新请求通过一个应用程序、边缘服务、身份验证层、存储服务和API,跟踪会显示时间累积的地方或请求失败的地方。
日志 提供事件级别的详细信息。它们可以包含堆栈跟踪、事务ID、响应code、捆绑版本或验证结果。日志解释了指标概括的本地情况和跟踪定位的内容。
实践规则: 指标告诉你问题存在,追踪显示问题发生的位置,日志解释了问题的原因。
考虑到实时更新失败的情况。一个指标报告更新验证错误增加。一个追踪跟踪一个失败的请求并显示包已经到达设备,但验证span失败。匹配的日志记录校验和结果并识别包版本。这些信号一起恢复了执行上下文,这些上下文是监控无法提供的。
相关性是工作机制
相关性需要共享的标识符和一致的属性。一个追踪ID应该跨服务边界传递。日志应该包含ID在可能的情况下。指标应该支持维度以帮助工程师缩小受影响的版本、渠道、设备家族或应用程序版本而不产生不可管理的唯一时间序列。
同样的方法在客户端也有效。假设用户点击一个功能并看到超时。客户端可以记录动作和应用程序版本,追踪可以跟踪网络请求,后端日志可以显示请求是否在身份验证或数据检索失败。工程师不需要从单个错误消息中推断整个故事。
处理大量日志的团队可以使用结构化字段和查询工具而不是依赖自由文本搜索。Capgo’s 日志分析工具提供了背景信息以使日志在调查期间更有用。 日志分析工具提供相关背景信息以使日志在调查期间更有用。
这三个柱子不是竞争产品。它们形成了一个因果链。指标提供了广泛的信号,跟踪减少了搜索区域,日志提供了详细的证据以便修复。
可观察性与监控的区别以及它们如何协同工作
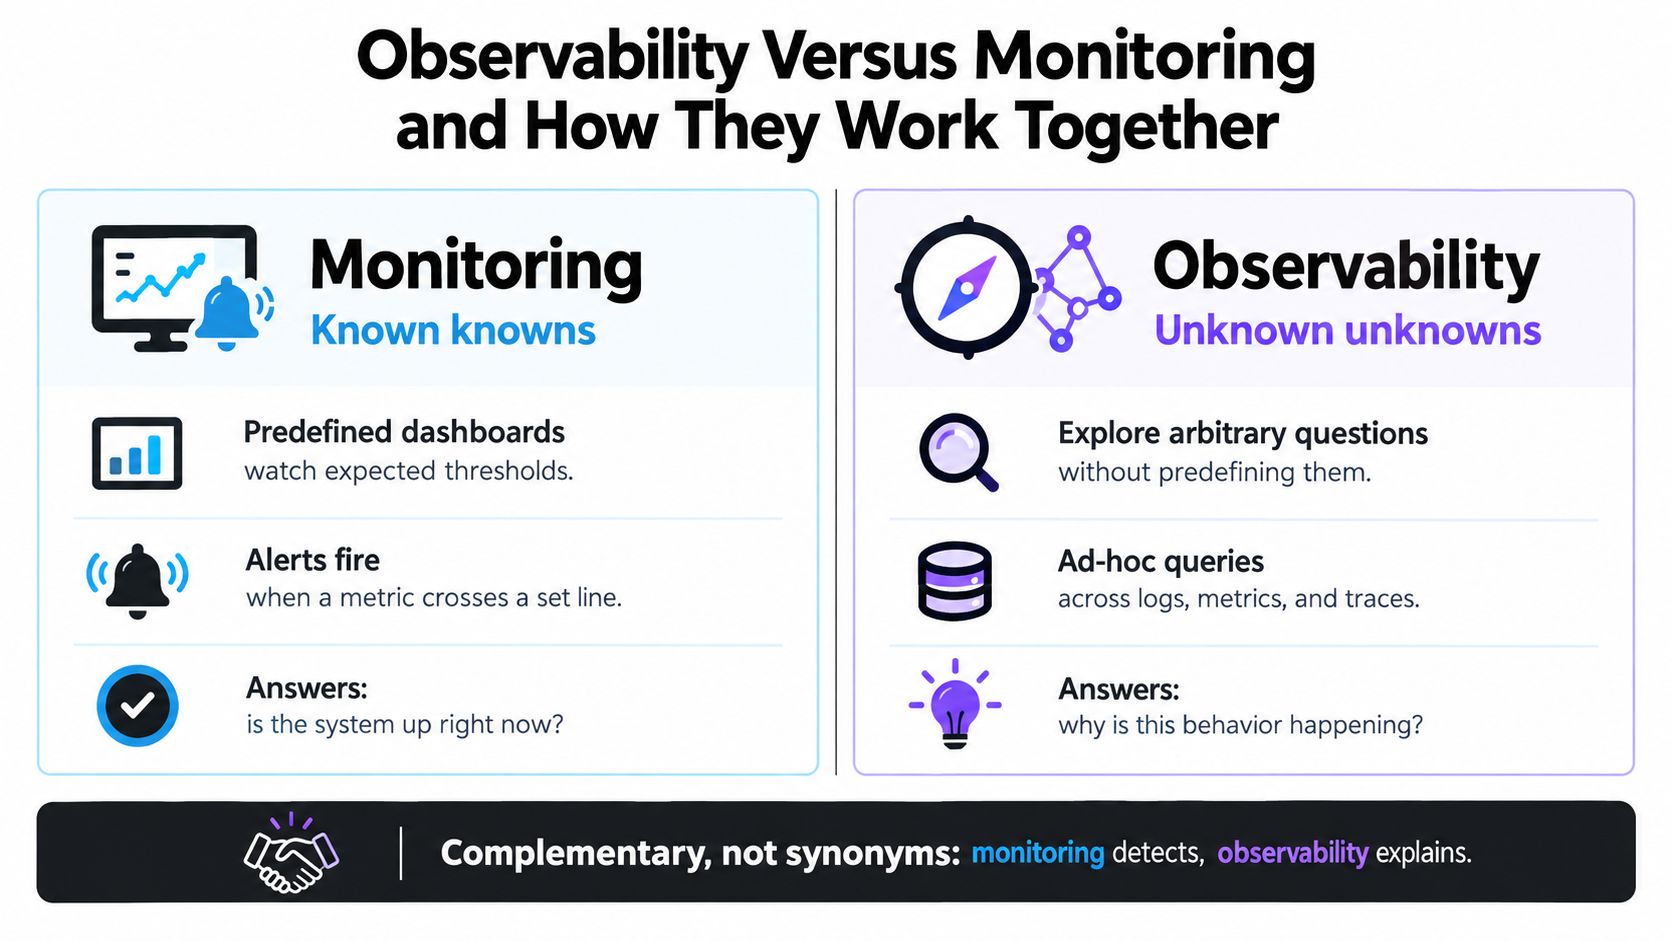
监控和可观察性相互支持,但它们不是同义词。监控会监控您已经决定的条件。可观察性会给您足够的连接数据来探索您没有预料到的行为。
一个监控规则可能会在API延迟超过阈值或更新失败超过预期水平时发出警报。这个警报是有价值的,因为它启动了响应。它并没有必要地告诉您问题的原因是否是后端回归、坏包、区域交付问题还是设备特定运行时问题。
| 能力 | 监控 | 可观察性 |
|---|---|---|
| 目的 | 观察已知健康指标 | 调查系统行为和不熟悉的故障 |
| 问题类型 | “这个阈值是否被超过?” | “为什么会出现这种行为?” |
| 数据方法 | 预定义仪表板和警报 | 相关日志、指标、跟踪和上下文 |
| 故障模式 | 没有配置的条件会被忽略 | 没有有用的指标化,变得昂贵或噪音 |
在事件循环中使用两者
健康的运营模式是简单的:
- 监控检测信号。 警报识别异常延迟、错误率、崩溃活动或更新失败。
- 可观察性框定事件。 工程师根据发布版本、渠道、设备、平台、地区或用户旅程进行过滤。
- 故障位置化。 请求路径揭示了行为发生变化的组件或跨度。
- 日志解释了条件。 详细记录显示了异常、验证结果、依赖性响应或配置涉及的内容。
- 团队验证了结果。 指标确认修复是否恢复了正常行为。
仅靠监控在稳定、可预测的条件下可能会很好地工作。然而,当系统频繁变化、故障跨越服务边界或用户运行多种版本和设备 combination 时,观察性变得更加重要。
一支移动团队可能会监控无故障的会话和更新采用率。当警报触发时,观察性让团队能够询问问题是否影响单个渠道、特定应用程序版本还是一类设备。这种调查是区分暂停每次发布并采取针对性的纠正行动之间的关键差异。
Capgo的 应用程序健康监控方法 与此区别相关的是,因为健康信号在团队可以将其连接到发布和设备上下文时变得更加有用。该工具不会取代一般的基础设施监控。它在应用程序生命周期中添加了运营证据。
观察性监控现在成为企业能力
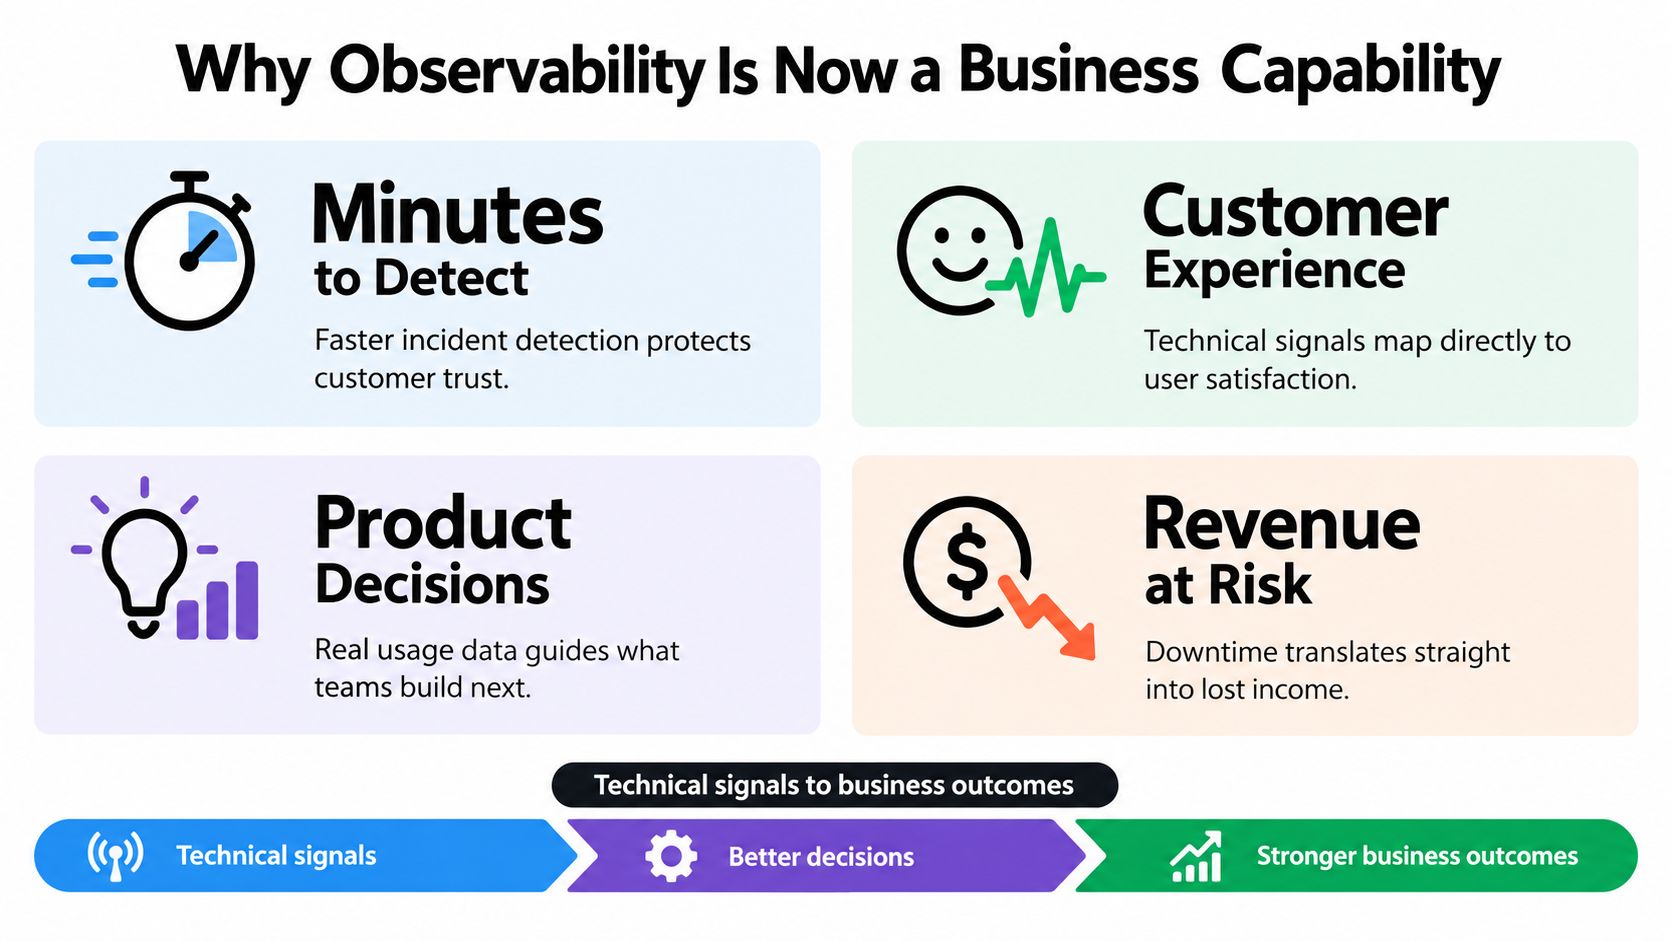
当其信号连接到客户体验和产品结果时,工程仪表板变成了一种商业工具。错误率上升会引起关注,因为它可能会阻止用户完成购买、登录、发送消息或使用新发布的功能。
需要有意识的设计来建立这种联系。团队应该将技术事件与有意义的商业上下文相关联,同时尊重隐私并避免不必要的个人数据。发布健康视图可能会结合采用状态、失败请求、用户旅程完成率和支持报告。产品经理可以看到一个功能是否适用于预期的受众,而不仅仅是服务是否响应。
超越事件响应的证据
Splunk 在 2025 的报告中指出, 74% 的受访者中 65% 认为可观测性对于监控关键业务流程很重要, 认为它是理解用户旅程的关键,正如其 2025 年可观测性报告
中所述。这些发现指出可观测性有更广泛的作用。它帮助团队将系统行为与客户和员工依赖的流程联系起来。 68% 许多组织在采用可观测性后,测量到的平均检测时间有所改善 2025 报告 在此处New Relic公告
.
- 更快的检测对运营有用,但业务价值出现在团队可以展示检测到的问题影响了什么以及响应是否改变了结果时 不同团队使用相同的证据
- 支持团队 可以确定一个投诉是否仅限于一个设备、版本或发布渠道
- 产品团队 可以比较功能行为跨发布版本和优先工作使用真实使用信号
- 工程团队可以将客户面临的问题连接到一个具体的服务、请求或客户事件 可以根据关键旅程评估运营风险,而不是抽象的基础设施状态。
Live Update 的发布过程展示了这一链条。如果采用率增长,但一部分用户无法激活,相关的商业问题不是更新端点是否可用。它是受影响用户是否能完成该更新旨在改善的任务。可观察性提供了回答这个问题并决定是否继续、暂停或回滚发布的证据。
实施模式最佳实践和权衡
良好的可观察性始于问题,而不是仪表板。添加监控之前,写下数据必须支持的决策。对于移动发布,可能包括:设备是否下载了捆绑包,是否通过验证,激活是否完成,更新后应用是否正常工作?
监控用户实际走的路径
从边界和结果开始:
- 客户生命周期: 记录启动、更新检查、下载、验证、激活和回滚事件。
- 服务边界: 将跟踪 ID 传播到应用、网关、后端和依赖服务。
- 失败上下文: 包括应用版本、捆绑包版本、频道、操作系统版本、设备类别和错误类别(适当时)
- 商业动作: 将技术请求连接到安全的、有意义的事件,如登录完成或支付失败。
使用结构化日志代替仅供人类阅读的段落。 一致的字段使过滤成为可能。 在收集数据扩大之前,定义保留规则,并将敏感信息排除在外。
完整性是跟踪完整度的有用衡量标准。 它意味着从分布式跟踪数据中可以重构的总请求数的分数。 关于可观察性评估的研究还指出,故障检测延迟、资源占用率、假阳性率和假阴性率以及成本是重要的衡量标准,正如本 可观察性评估调查.
在诊断深度和开销之间取得平衡
更多的遥测并不一定更好。 收集数据可能会消耗CPU、内存、带宽和存储,尤其是在移动设备或高容量服务上。 采样可以控制数据量,但要有目的地采样。 保留详细的跟踪记录以便于错误、异常延迟、发布分组和重要工作流程的分析,同时保留低成本的广泛指标以便于趋势可见性。
有用的信号是让响应者做出下一个正确决策所需的最小证据集。
在事件发生后审查数据。 如果没有人查询一个字段,删除它或更改其目的。 如果工程师仍然需要手动重现问题,添加缺失的上下文而不是增加每个日志级别。
对于Capacitor团队,一个专注的 性能监控设置指南 可以帮助将这些原则转化为客户端的监控。从一个关键用户旅程开始,建立其正常行为,然后随着团队学习哪些问题重复出现而扩大覆盖范围。
Capacitor Electron 和 Capgo Live Updates 的可观察性实践
Capacitor 或 Electron 团队可能需要在用户继续运行安装应用程序时修复 JavaScript、CSS、复制、配置或 Web 资产。Live-update 生命周期创建了自己的可观察路径:设备检查更新,接收来自频道的包,验证它,激活它,并报告结果。
考虑一下团队准备的 JavaScript 修复。它将包发布到测试或 beta 频道,然后分配一个受控的受众。采用度指标显示设备是否接收了发布。失败度指标显示下载、验证或激活是否失败。版本历史记录显示每个设备应该运行哪个包。
然后团队发现了一个设备特定的问题。每个设备的日志显示受影响的安装下载了包但验证失败。工程师可以将设备的当前版本、频道和更新历史与成功安装的版本、频道和更新历史进行比较,而不是将其视为一般性停机。
滚动发布需要引导线
安全的滚动发布使用相同的告诉、定位、解释模式:
- 指标告诉 是否采用和失败行为发生了变化。
- 每个设备的记录定位 受影响的群体或安装。
- 日志解释 下载失败、校验、激活或运行事件。
- 频道控制限制 在团队调查期间控制爆炸半径。
- 回滚保护恢复 当新版本不安全时,恢复到之前的可工作包。
对于 Electron 和移动应用程序来说,这个工作流程也很重要。桌面用户可能有不同的操作系统环境、权限、网络条件和安装的版本。一个识别出当前活跃包的发布视图可以为支持和工程团队提供一个共享的答案:‘这个用户正在运行什么?’
团队还可以在更新事件旁边跟踪产品事件。Capgo的 自定义事件跟踪插件 支持更广泛的原则,即发布监控在连接部署状态和应用程序行为时变得更有价值。该平台可以提供每设备的日志、采用和失败指标、版本历史、目标频道和自动回滚保护。
从一个生产频道和一个关键旅程开始。定义发布信号、附加一致的版本和设备上下文、在事件发生之前测试回滚、并让某人负责在每次发布后审查证据。
Capgo为 CapacitorJS 和 Electron 应用程序提供实时更新、目标频道、每设备发布可见性、采用和失败指标、版本历史和回滚保护。使用该发布可观察性来连接发生了什么与用户体验,然后访问 Capgo 为了评估它以适合您的下一个更新流程。





