

La plupart des outils de mise à jour OTA peuvent envoyer un nouveau bundle. Beaucoup moins montrent ce qui se passe après l’installation par les utilisateurs. Ce guide explique comment évaluer ces signaux et où Capgo conviennent aux équipes Ionic et Capacitor.
Table des matières
- Capgo
- Étape 2 : Définissez les signaux de mise à jour que votre équipe doit surveiller
- Étape 3 : Connectez l'analytics temps réel au workflow de mise à jour
- Étape 4 : Déployez par canal, pourcentage et risque utilisateur
- Étape 5 : Diagnostiquez les échecs grâce au contexte des crashs et performances
- Étape 6 : Automatisez le déploiement et comparez la couverture des analytics
- FAQ
- Conclusion
1. Capgo
Commencez avec Capgo quand votre équipe a besoin d'un seul chemin de mise à jour pour le contrôle des releases, les données en temps réel, le rollback et le CI/CD. Capgo est conçu pour les apps Ionic et Capacitor, où un bundle de la couche web peut souvent être déployé sans attendre un nouveau build natif ni une validation par les stores.
Capgo relie la livraison OTA aux signaux dont vous avez besoin après une release. Vous pouvez publier un bundle en une seule commande, le placer derrière un canal, suivre son adoption, puis faire un rollback si les données indiquent une mauvaise release. Un canal est une voie de release nommée, comme beta, QA ou production. Il permet de garder les testeurs à l'écart de l'audience principale.
L'aspect le plus utile, c'est la boucle de feedback. Un déploiement doit répondre rapidement à quatre questions :
- Le bundle a-t-il atteint les utilisateurs visés ?
- Les installations ont-elles réussi ?
- Les erreurs ou crashs ont-ils augmenté après l'adoption ?
- Peut-on stopper la release sans attendre que chaque utilisateur mette à jour ?
Les données de fonctionnalités de Capgo couvrent les analytics en temps réel, les déploiements progressifs par canal, le rollback automatique et l'intégration CI/CD. Dans l'ensemble comparatif utilisé pour cette étude, c'était la seule solution cochée « oui » sur les quatre critères. Cela fait de Capgo un point de référence utile pour évaluer d'autres outils, même si votre équipe de release est réduite.
Capgo prend également en charge les mises à jour différentielles. Le client ne reçoit que la partie modifiée d'un bundle au lieu de télécharger le package entier à chaque fois. Des mises à jour plus légères réduisent le volume transféré, ce qui compte lorsque les utilisateurs mettent à jour sur un réseau mobile faible ou sur un lieu de travail très fréquenté.
La sécurité doit rester un critère de décision. Les changements OTA affectent code qui s'exécute sur l'appareil de l'utilisateur : votre équipe doit donc définir qui peut publier, quels canaux sont accessibles et comment les bundles sont vérifiés. Capgo offre des contrôles de sécurité de niveau entreprise pour son flux de mise à jour. Nous recommandons toujours de tester les permissions sur un canal hors production avant de donner l'accès aux releases.
La tarification se fait par abonnement par organisation, et non par achat unique ou par siège. Capgo propose un essai gratuit de 14 jours, ce qui laisse le temps à votre équipe de connecter une app de test et de vérifier tout le parcours de release avant de choisir un plan.
Pour examiner de plus près les signaux disponibles lors d'une release, consultez ces métriques de mise à jour en temps réel des apps Capacitor. Le bon test est simple : publier un bundle inoffensif, surveiller son statut, puis faire un rollback.
Étape 2 : Définissez les signaux de mise à jour que votre équipe doit surveiller
La meilleure configuration d’analytics pour les mises à jour d’app en temps réel commence par une courte liste de signaux. N’ouvrez pas un dashboard pour collecter tous les chiffres affichés. Décidez quels événements influencent la décision de release.
Commencez par la livraison des mises à jour. Suivez le nombre d’appareils éligibles à un bundle. Puis distinguez ces états :
- Éligible mais non contacté.
- Téléchargement démarré.
- Téléchargement terminé.
- Installation terminée.
- Échec de la mise à jour.
- Rollback déclenché.
Ces états évitent une erreur courante. Un nombre élevé de téléchargements peut sembler bon signe alors que les installations échouent à l'étape finale. Gardez le succès des téléchargements et celui des installations comme des mesures distinctes. Ajoutez la version de l'app, le système d'exploitation, le type d'appareil, le canal et le bundle ID à chaque événement.
Ensuite, identifiez les signaux qui montrent l'impact sur l'utilisateur. Le taux d'utilisateurs sans crash indique combien d'utilisateurs ont évité un crash sur une période donnée. Le taux de sessions sans crash s'intéresse quant à lui aux sessions. Ils répondent à des questions différentes, ne les fusionnez donc pas en un seul score.
La rétention nécessite une vue par cohorte. Regroupez les utilisateurs par date ou par release de première installation du bundle, puis comparez l'activité au jour 1, au jour 7 ou au jour 30. La rétention agrégée peut masquer une baisse quand les nouvelles installations augmentent. Le suivi par cohorte offre une vue plus claire qu'un total global ; voir les métriques d'analytics mobile.
Utilisez les événements métier avec prudence. Une release peut s'installer sans provoquer de crash, mais tout de même casser l'inscription ou le paiement. Suivez l'étape du tunnel qui compte pour votre app. Pour une app de service sur le terrain, cela peut être l'ouverture d'un ordre de travail. Pour une app payante, cela peut être la finalisation d'un upgrade.
Gardez le premier dashboard simple. Nous suggérons une vue de release avec ces groupes :
- Livraison : appareils éligibles, téléchargements, installations et échecs.
- Qualité : utilisateurs sans crash, taux d'erreur, temps de démarrage et freezes.
- Adoption : appareils actifs par bundle et par canal.
- Produit : un ou deux événements liés à l'objectif de la release.
Définissez une baseline avant le déploiement. Utilisez le bundle de production actuel comme point de comparaison. Si le nouveau bundle affiche un taux d'erreur plus élevé, vous avez besoin d'une référence pour savoir si le changement est nouveau ou normal.
À retenir : Un dashboard de release doit déboucher sur une action : continuer, mettre en pause, investiguer ou faire un rollback.
Ne définissez pas les seuils d'alerte à partir d'un benchmark générique. Une application de voyage a un modèle d'utilisation différent d'une application de chat. Choisissez vos seuils à partir de vos propres données de production récentes, puis ajustez-les lorsque l'application ou l'audience change.
Étape 3 : Connectez l'analytics temps réel au workflow de mise à jour
L'analyse en temps réel des mises à jour d'application devient utile lorsqu'elle s'intègre au parcours de release. Votre pipeline CI/CD doit compiler le bundle, identifier le commit, publier le bundle sur un canal sûr et envoyer les métadonnées de la release à votre vue d'analyse.
Commencez par nommer la release. Utilisez un ID de bundle qui relie la version de l'application à un commit ou à un enregistrement de build. Ajoutez le responsable de la release et une courte note de changement. Cela fait gagner du temps lorsqu'une alerte arrive plusieurs heures plus tard.
Ensuite, connectez le CLI. Un CLI, ou interface en ligne de commande, permet à un script d’exécuter la même commande de release à chaque fois. Stockez les identifiants dans votre gestionnaire de secrets CI/CD. Ne les placez jamais dans un dépôt ou dans un log où ils pourraient être copiés.
Construisez le pipeline par étapes :
- Exécutez les tests de la couche web et du wrapper natif.
- Compilez le bundle signé.
- Publiez sur un canal de test.
- Attendez les premiers health checks.
- Promouvez le bundle vers un groupe de production limité.
- Pause or roll back when a rule fails.
La pause est essentielle. Un pipeline qui publie sans point d'arrêt peut propager une mauvaise mise à jour avant que quiconque ne voie la première erreur. Traitez la promotion comme une commande distincte, même si le même job l'exécute plus tard.
Capgo prend en charge le déploiement en une seule commande et l'intégration CI/CD, afin que l'étape de mise à jour trouve sa place aux côtés du reste de votre travail de release. Les équipes peuvent garder les builds natifs dans le même processus tout en envoyant les changements de la couche web via un canal OTA. Cette séparation est utile quand le correctif ne nécessite pas un nouveau binaire natif.
Utilisez un webhook ou un événement API pour lier l'état de la mise à jour à votre système d'alerte. Le payload doit inclure l'ID du bundle, le canal, le groupe cible, l'état d'installation et le contexte de l'erreur. Si votre outil d'analytics ne peut pas identifier quelle release a causé un événement, il affichera un symptôme sans la cause.
Gardez votre première automatisation restreinte. Automatisez la publication sur un canal de test avant d'automatiser la promotion en production. Demandez à une personne qui n'a pas écrit le changement d'exécuter l'exercice de rollback. Un processus de récupération que seul son auteur comprend n'est pas prêt pour une release nocturne.
Surveillez la première phase d'un déploiement progressif avant de l'étendre. Le temps d'attente exact dépend du trafic et du risque. Un changement de paiement nécessite une surveillance plus rapprochée qu'une correction de texte.
Pour les équipes qui construisent leur release autour du contrôle de version, ce workflow peut aider à cartographier la transition entre le build, la publication, l'observation et le rollback.
Étape 4 : Déployez par canal, pourcentage et risque utilisateur
Utilisez des canaux et des pourcentages pour limiter l'exposition pendant que les meilleurs outils d'analytics des mises à jour d'app en temps réel collectent des données. Un canal est la couche de contrôle. Un pourcentage correspond à la taille de l'audience dans cette couche.
Prévoyez un plan de canaux avant de publier. Une petite équipe peut utiliser :
- Développement : les builds internes et les vérifications locales.
- QA : des tests répétables sur appareils et flux.
- Bêta : volunteer users who accept some risk.
- Production : la base d'utilisateurs principale.
Gardez des règles des canaux claires. Notez qui peut promouvoir un bundle et quels contrôles doivent passer en premier. Le nom d'un canal doit indiquer au prochain ingénieur à quoi il sert. Évitez les libellés qui n'ont de sens que pour la personne qui les a créés.
Choisissez le premier groupe selon le risque. Les utilisateurs internes sont utiles pour vérifier un lancement de base. Ils ne révéleront pas toujours un problème de réseau régional ou un crash spécifique à un appareil. Si vos données permettent la segmentation, incluez un petit mélange de systèmes d’exploitation et de classes d’appareils dès le départ.
Ensuite, définissez le pourcentage de déploiement. Commencez avec un public limité. Surveillez les signaux de livraison et de produit ensemble. Si les installations augmentent mais qu’une action clé diminue, mettez le déploiement en pause, même si le taux de téléchargement semble correct.
Le rollback automatique modifie le temps de réponse. Sans lui, quelqu’un doit voir l’alerte, confirmer que la release en est la cause et exécuter une commande de récupération manuelle. Avec une règle de rollback définie, le système peut ramener les utilisateurs vers un bundle connu lorsque la release dépasse cette limite.
Les règles de rollback nécessitent des garde-fous. Définissez un nombre minimum d’événements pour qu’un seul appareil de test ne puisse pas déclencher une récupération complète. Limitez la règle au canal ou au bundle concerné. Enregistrez chaque rollback avec son déclencheur et son responsable. Sinon, l’équipe pourrait corriger la release alors que la cause reste floue.
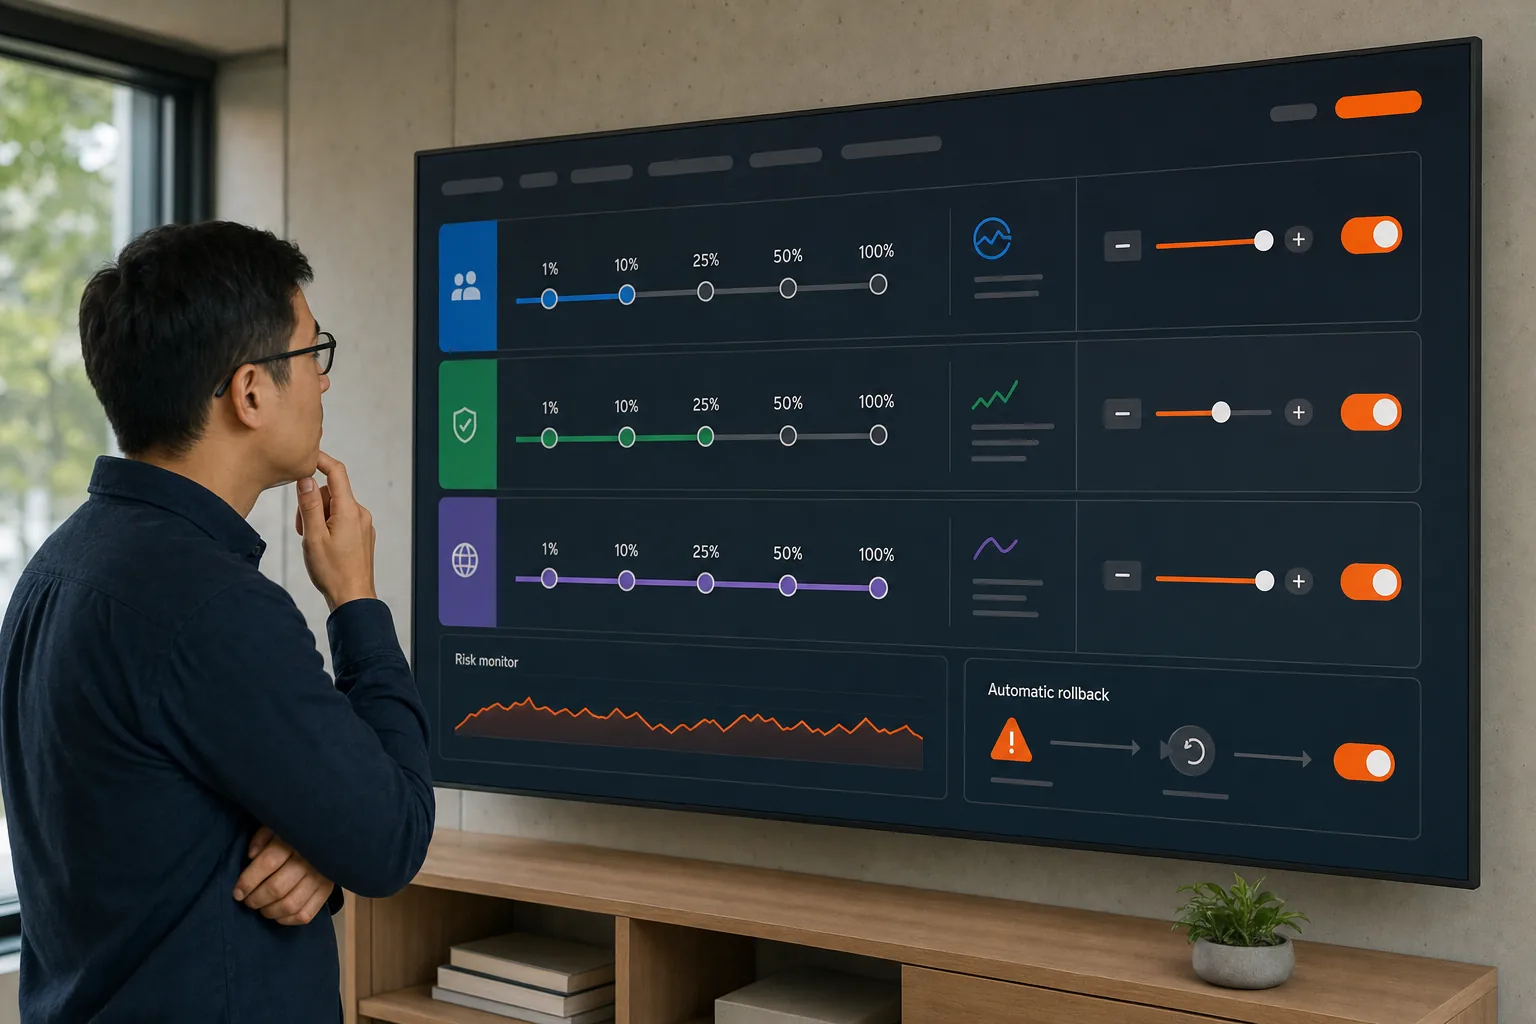
Capgo prend en charge les déploiements progressifs par canal et le rollback automatique. Ce duo est facile à négliger quand les équipes comparent les outils uniquement sur la distribution des téléchargements. Un staging sans reprise laisse encore quelqu'un d'astreinte.
Conseil de pro : Rédigez la règle de rollback avant de publier. Si l'équipe débat du seuil pendant un incident, c'est trop tard.
Utilisez une note de release qui indique ce qui a changé et ce qu'il faut surveiller. « Mettre à jour les dépendances » est trop vague. « Synchro hors ligne modifiée après un bon de travail terminé » donne à la personne d'astreinte un chemin de test.
Lorsque le premier groupe reste sain, élargissez par petites étapes. Si un signal se dégrade, arrêtez d'abord la promotion. Comparez ensuite le nouveau bundle à la dernière version valide connue.
Étape 5 : Diagnostiquez les échecs grâce au contexte des crashs et performances
Les analytics peuvent vous dire qu'une release OTA échoue. Le contexte des crashs et des performances aide à expliquer pourquoi. La vue utile associe l'ID du bundle à l'utilisateur concerné, l'appareil, l'état de l'application et le chemin de l'événement.
Commencez par le premier signal négatif. Le taux de crash a-t-il augmenté après l'installation ? Le démarrage a-t-il ralenti ? La mise à jour a-t-elle échoué avant le chargement de l'application ? Chaque motif pointe vers une partie différente du chemin de release.
- Échecs d'installation : vérifiez l'intégrité du bundle, la compatibilité et les conditions réseau.
- Échecs de démarrage : inspectez code qui s'exécute avant le premier écran.
- Erreurs de fonctionnalité : comparez le parcours modifié avec la release note.
- Écrans lents : vérifiez les nouveaux travaux au lancement ou après navigation.
- Baisse de conversion : inspectez l'étape exacte du tunnel concernée.
Décomposez chaque signal par canal et par bundle. Une moyenne globale peut masquer un crash limité à une seule release. Ajoutez la géographie uniquement si elle aide à isoler un problème de réseau ou de service. Trop de filtres ralentissent la première réponse.
Regardez les utilisateurs en plus des sessions. Un utilisateur peut ouvrir l'application plusieurs fois après une mise à jour échouée. Compter uniquement les sessions peut faire paraître l'échec plus ou moins important que le nombre de personnes affectées.
Les performances nécessitent une base de référence. Comparez le temps de démarrage et le temps de chargement des écrans clés avec le bundle précédent. Ne comparez pas une nouvelle release pendant un pic de trafic avec une ancienne release plus calme, sauf si vous signalez cette différence.
Le session replay peut aider lorsque les données d'événements indiquent « échec du paiement » mais ne montrent pas l'état de l'écran. Il peut révéler un bouton bloqué, une boucle ou un problème de mise en page qu'une stack trace ne peut pas décrire. Le timing des événements de suivi de l'engagement en temps réel peut aider à expliquer ce qu'un utilisateur a fait après l'apparition du contenu.
Préservez la confidentialité dans le workflow. Supprimez les secrets des logs. Évitez d’envoyer des détails de paiement ou du texte privé dans les propriétés d’événements. Donnez au support une vue minimale, juste assez pour associer une réclamation à une release.
Une fois une cause probable identifiée, stoppez le déploiement progressif avant de patcher. Publiez le correctif sur un canal de test. Répétez ensuite le même chemin d’échec. Un rollback protège les utilisateurs, mais ne prouve pas que le prochain bundle est sûr.
À retenir : Reliez toujours une erreur à un bundle, un canal, un groupe d'appareils et une action utilisateur spécifiques avant de changer la release.
Teams that need more detail can use Capgo’s configuration du monitoring de performance pour Capacitor comme point de départ pour les vérifications d'erreurs et de performance.
Étape 6 : Automatisez le déploiement et comparez la couverture des analytics
Comparez les outils selon les décisions qu'ils permettent de prendre, pas selon le nombre de cartes dans le dashboard. Le meilleur workflow d'analytics en temps réel pour les mises à jour d'app doit vous aider à suivre l'adoption, mettre en pause l'exposition, effectuer un rollback en toute sécurité et relier la release à votre CI/CD.
Le tableau ci-dessous reprend les champs de recherche collectés pour 12 plateformes de mise à jour OTA. Un tiret signifie que les données sources n'indiquaient pas clairement « oui » pour ce champ. Un texte présent dans la description d'un fournisseur peut ne pas ressortir comme un « oui » dans le flag de fonctionnalité extrait ; considérez donc ce tableau comme une aide au tri, et non comme un audit complet du produit.
| Option | Signal d'analytics en direct | Déploiement progressif par canal | Rollback automatique | Signal CI/CD | Idéal pour |
|---|---|---|---|---|---|
| Capgo | Oui | Oui | Oui | Oui | les équipes Capacitor qui veulent un cycle de release unique |
| RNPush | Livraison CLI et suivi du taux de crash | Oui | Oui | — | déploiements progressifs React Native |
| Mender | — | — | Oui | — | Équipes de récupération des mises à jour d'appareils |
| Memfault | Dashboards de crash, de performance et de flotte | Oui | Non | — | Diagnostic de flotte et télémétrie |
| AWS IoT Jobs | État des tâches et métriques CloudWatch | Oui | Non | Services AWS répertoriés | Workflows d’appareils basés sur AWS |
| Azure Device Update for IoT Hub | Suivi des mises à jour et de la conformité | Oui | — | Azure DevOps et GitHub | Gestion de flotte Azure |
| Balena | — | — | Non | — | Équipes évaluant les mises à jour d'appareils gérés |
| Particle | — | Oui | Non | — | Équipes appareils nécessitant un déploiement par canal |
| Capawesome Cloud | — | Déploiement progressif | Oui | — | Capacitor équipes évaluant les contrôles de déploiement progressif |
| Expo | Métriques de lancement et de mise à jour | — | — | — | Expo app teams reviewing update data |
| Ionic Appflow | — | Test, QA, production | Manuelle | Cloud CLI | Équipes Ionic utilisant des stades d’environnement |
| Revopush | Visibilité du déploiement et des installations | — | — | Bitrise, CircleCI, GitHub Actions | Équipes disposant de hooks CI/CD existants |
Lisez le tableau en vous demandant ce qui se passe lors d’une mauvaise release. Le système peut-il afficher le bundle concerné ? Peut-il stopper la promotion suivante ? Peut-il ramener les utilisateurs à la dernière version connue comme saine ? Votre pipeline peut-il publier sans étape de copie-coller manuelle ?
L’accès gratuit est également inégal. Capgo propose un essai gratuit de 14 jours lié à son modèle d’abonnement par organisation. Utilisez cet essai pour tester un parcours complet, pas seulement le dashboard. Compilez, publiez, installez, observez, mettez en pause et effectuez un rollback.
Effectuez le même test sur toute plateforme en cours d’évaluation. Utilisez une petite application Capacitor. Ajoutez une modification de texte inoffensive. Envoyez-la vers un canal de test. Simulez ensuite une installation échouée ou une augmentation du taux d’erreurs. Le gagnant pour votre équipe est l’outil qui rend la réponse claire sans ajouter un second système d’exploitation.
Gardez votre pipeline simple. Une commande prévisible et un état de release visible valent mieux qu’un workflow ingénieux que seul un ingénieur peut maintenir.
FAQ
Qu’est-ce que l’analytics temps réel des mises à jour ?
Les analytics en temps réel des mises à jour d’app montrent ce qui se passe quand les utilisateurs reçoivent et exécutent un nouveau bundle. Elles peuvent inclure l’état du téléchargement, le succès de l’installation, l’adoption par canal, les erreurs, les crashs et les événements produit. Pour les équipes qui comparent les outils d’analytics des mises à jour, le test utile consiste à savoir si les données arrivent assez tôt pour suspendre un déploiement progressif ou déclencher une reprise.
Quels signaux suivre après une release OTA ?
Suivez le succès de l’installation, les échecs de mise à jour, l’adoption du bundle, les utilisateurs sans crash, les performances au démarrage et un événement métier lié au changement. Les bons signaux pour les analytics en temps réel des mises à jour d’app dépendent de votre application. Une release du checkout a besoin de données sur le parcours d’achat. Un workflow hors ligne a besoin d’événements de synchronisation et de reprise.
Can Capacitor apps use real-time OTA analytics?
Oui, les applications Capacitor peuvent associer la livraison OTA aux analytics des mises à jour et de la santé de l’app. Capgo est pensé pour les équipes Ionic et Capacitor, et relie la livraison des bundles aux canaux, au rollback et au CI/CD. Testez le parcours complet avec une petite app avant la production. Vérifiez que chaque événement inclut l’ID du bundle et le canal.
Why do channels matter for app updates?
Les canaux permettent d’envoyer un bundle à un groupe nommé avant une release plus large. Cela facilite les tests séparés auprès des utilisateurs beta, QA ou production. Dans un workflow d’analyse, les canaux indiquent aussi quel public a rencontré le problème. Ajoutez des contrôles de pourcentage quand vous devez élargir l’exposition par étapes mesurées.
Le rollback automatique doit-il faire partie d’un outil OTA ?
Le rollback automatique est utile lorsqu’une release peut causer des dégâts avant qu’une personne n’intervienne. Définissez un déclencheur clair basé sur un nombre suffisant d’événements, puis ramenez les utilisateurs affectés vers un bundle connu comme fiable. L’analyse en temps réel des mises à jour d’app aide à détecter le problème, tandis que le rollback fournit l’action de récupération. Conservez un override manuel pour les incidents inhabituels.
Conclusion
Choisissez Capgo si votre équipe Ionic ou Capacitor veut des données de release en temps réel, le contrôle des canaux, le rollback automatique et du CI/CD dans un seul workflow de mise à jour. Démarrez l’essai gratuit de 14 jours avec une app de test, publiez un bundle inoffensif et faites un exercice de rollback avant de passer en production.




